 software-architecture.ai
Von Jörg Amelunxen
Softwarequalität · KI-Entwicklung
Softwarequalität sichern, wenn KI den Code schreibt:Welcher Nachweis schützt welche Regel?
Was man bei der Abnahme hört
Alle Tests grün. Die Software funktioniert.
Was es tatsächlich heißt
Grün heißt: Code und Test sind sich einig. Ob sie sich im Richtigen einig sind, hat damit noch niemand geprüft.
Abnahmebericht
Beispiel1.248 Testsalle grün · 87 % Testabdeckung
Ansicht: Was der Bericht zählt. Alle fünf Regeln sind abgehakt.
Regeln, die nie brechen dürfen
- 1Eine Abrechnung geht nie an den falschen Haushalt.bestanden
- 2Eine Rechnung geht nie doppelt raus.bestanden
- 3Was gespeichert ist, ist nach einem Neustart noch da.bestanden
- 4Gesperrt schlägt freigegeben.bestanden
- 5Ohne zweite Freigabe keine Auszahlung über 500 Euro.bestanden
Dienstag, 16:40 Uhr, Abnahme
Maren (fiktiver Name) führt eine Hausverwaltung mit neun Leuten. Vor ihr liegt der Bericht ihres Dienstleisters: 1.248 Tests, alle grün, 87 Prozent Testabdeckung. Sie nickt. Mittwoch früh legt eine Kollegin eine Abrechnung an, das Programm startet einmal neu, und die Abrechnung ist weg. Kein einziger der 1.248 Tests ist rot.
Maren und ihre Zahlen sind erfunden. Das Muster dahinter ist echt, und die Forschung dazu kommt gleich. Die Frage für dich: Wie kannst du Softwarequalität sichern, wenn eine KI den Code schreibt und die Tests gleich mit? Wie testest du KI-generierten Code so, dass ein grüner Haken etwas bedeutet?
Dieser Text ist für dich, wenn dir jemand Software hinstellt und du entscheiden musst, ob du sie abnimmst. Unit-Tests schreibst du nicht, das ist die Aufgabe deines Dienstleisters. Deine Frage ist eine andere: Woran erkennst du bei der Abnahme, dass die Software tut, was dein Geschäft braucht?
Die gute Nachricht zuerst: Du musst dafür keinen Code lesen. Du brauchst fünf Sätze über dein Geschäft und eine Frage, die du zu jedem dieser Sätze stellst. Als kleiner Betrieb bist du hier im Vorteil, denn du kennst deine Regeln. Ein großes Unternehmen mit 5.000 Regeln braucht dafür eine Abteilung. Für deinen Teil reicht ein Blatt Papier.
Ich nenne sie
die Nachweisfrage
Welcher Nachweis schützt diese Regel? Eine Regel ist ein Satz über dein Geschäft, der nie brechen darf: „Eine Rechnung geht nie doppelt raus.“ Ein Nachweis ist etwas, das eine Maschine ausführen kann und das rot wird, sobald die Regel bricht.
Jede wichtige Regel verdient einen Nachweis, genau dort, wo ein Fehler wehtun würde.
01
Woran erkennst du Softwarequalität, wenn alle Tests grün sind?
An den Regeln, die nachweislich halten. Ein grüner Haken zeigt zunächst nur, dass Code und Test sich einig sind.
Ein Fall, der in der Softwareentwicklung regelmäßig vorkommt: Hunderte Testdateien, und nur eine Handvoll Prüfungen, die das Produkt so benutzen, wie ein Mensch es benutzt. Ein Teil der Tests prüft, ob ein Schildchen die richtige Farbe hat. Auffällig wird das bei einem Umbau, bei dem sich für niemanden etwas ändert und trotzdem Dutzende Tests rot werden. Umgekehrt gibt es Dinge, die wirklich kaputt sind, und alles bleibt grün.
Was sagt so ein grüner Haken also aus? Drei Begriffe helfen beim Einordnen.
Ein Unit-Test prüft ein einzelnes kleines Bauteil für sich. Wie die Prüfung, ob ein Ziegel den Druck aushält.
Die Testabdeckung, englisch Code Coverage, sagt, wie viel vom Code beim Testen durchlaufen wurde. Ob jemand hingeschaut hat, was dabei herauskam, sagt sie nicht. 87 Prozent heißt: 87 Prozent der Zeilen wurden einmal angefasst.
Und dann gibt es die Attrappe, Fachwort Mock. Damit ein Test schnell läuft, ersetzt man die Datenbank, den Bezahldienst oder das Mailprogramm durch eine Attrappe, die immer brav antwortet.
Stell dir vor, du probst dein Kreditgespräch mit deinem Schwager, der die Bank spielt. Er sagt ja, und du gehst beruhigt nach Hause. Die echte Bank hat andere Formulare. Genau so arbeitet ein Test gegen eine Attrappe. Er beweist, dass dein Code mit deiner Vorstellung von der Datenbank klarkommt. Ob die Vorstellung stimmt, zeigt erst die echte Datenbank. Ich nenne das Mock-Theater: Test und Code teilen dieselbe falsche Annahme. Und beide spielen ihre Rolle perfekt. Deshalb muss zuerst abgesichert sein, dass die Attrappe dieselbe Schnittstelle hat wie das echte System: dieselben Fragen versteht und in derselben Form antwortet. Das ist die Aufgabe deines Dienstleisters, nicht deine. Es hilft aber zu verstehen, was Qualität hier überhaupt bedeutet.
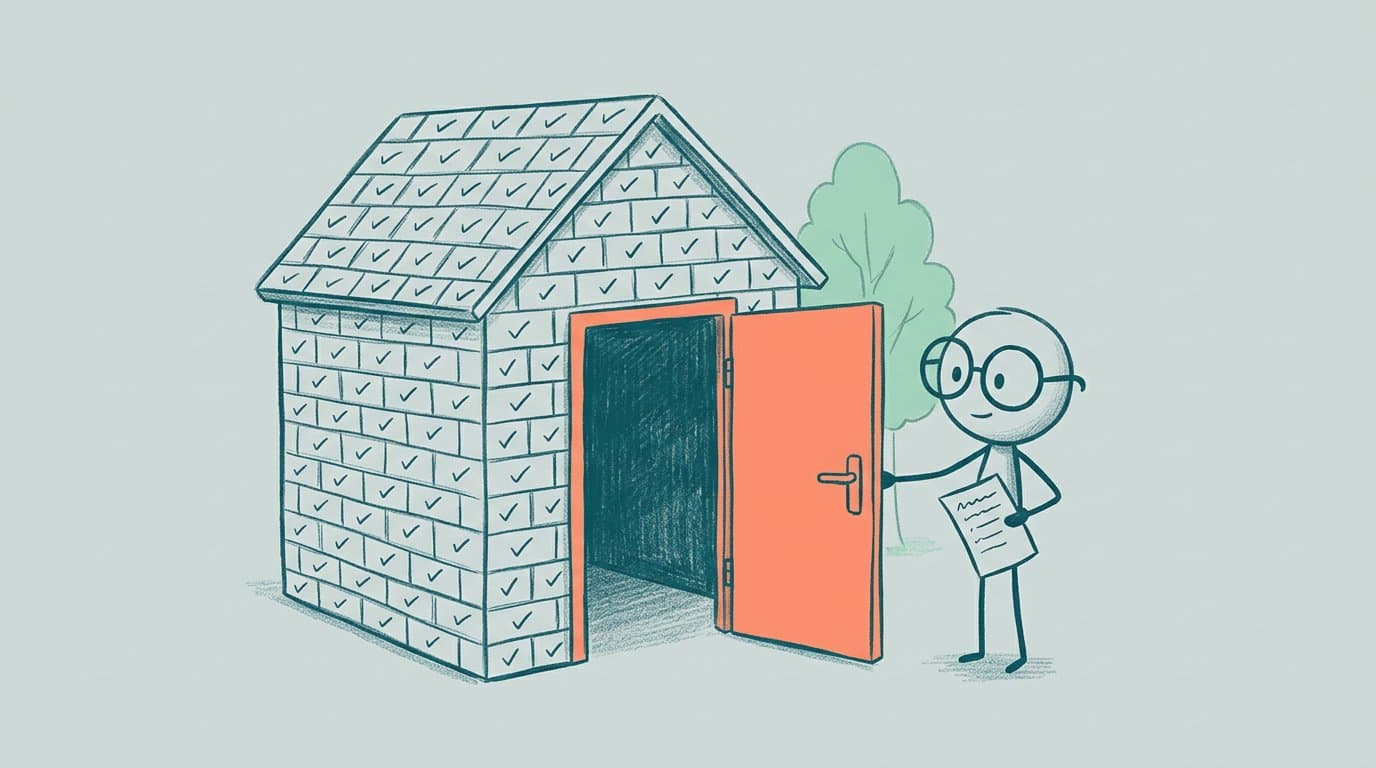
Jeder Ziegel geprüft. Das Haus nie betreten.

Ein Forschungsteam um Asma Hamidi hat diesen Ablauf nachgestellt. Fünf Sprachmodelle schrieben Code und die Tests dazu, über 6.000 fehlerhafte Programme kamen zusammen. Das Ergebnis in ihren Worten: Die tatsächliche Fehlererkennung bleibt extrem niedrig, oft nahe null (Quelle: Hamidi et al., 2026). Die Tests laufen durch die kaputte Stelle, aber sie fragen dort nicht das Richtige ab. Fairerweise: Es ist eine Vorabveröffentlichung, und einfache Fehler werden laut derselben Arbeit gut gefunden. Das Problem sind die schwierigen.
Eine zweite Arbeit von der Universität Toronto hat über 100.000 KI-geschriebene Testfälle von elf Modellen ausgewertet. Sobald man nicht sicher weiß, ob der getestete Code selbst stimmt, ist die Testabdeckung kein verlässliches Zeichen mehr dafür, ob Fehler gefunden werden (Quelle: Zhao, Zhou und Cohen, 2026). Auch das gehört dazu: Gilt der Code als korrekt und sollen die Tests nur künftige Änderungen absichern, taugt die Abdeckung durchaus als Signal. Coverage ist ein Diagnosewert. Ein Qualitätsurteil ist sie nicht.
Marens Bericht war wahr. Er hat nur eine Frage beantwortet, die sie nie gestellt hatte.
Die tatsächliche Fehlererkennung bleibt extrem niedrig, oft nahe null.
02
Was ändert sich, wenn KI die Tests schreibt?
Tests kosten fast nichts mehr. Damit verliert ihre Menge den Wert als Maßstab.
Das mit den grünen Haken war schon immer so. Warum wird es gerade jetzt zum Thema? Weil sich der Preis eines Tests geändert hat. Früher war ein Test teuer. Wer 1.000 Tests hatte, hatte tausendmal nachgedacht. Heute bestellt man 1.000 Tests in einem Satz. Der Agent liefert, bevor der Kaffee durch ist.
Wie verbreitet das ist, zeigt eine Zahl. Bei Stack Overflow ist der Anteil der Entwickler:innen, die KI-Agenten nutzen, innerhalb eines Jahres von 31 auf 59 Prozent gestiegen (Quelle: Stack Overflow, 2026). Das ist eine kleinere Zwischenumfrage vom April, die große Jahresumfrage 2026 war beim Schreiben noch nicht erschienen.
Was machen die Agenten anders? Eine Studie von der Konferenz MSR 2026 hat 1,2 Millionen Änderungen aus 2.168 Projekten ausgewertet. 23 Prozent der Änderungen von KI-Agenten fassen Tests an, bei Menschen sind es 13 Prozent. 36 Prozent der Agenten-Änderungen bauen Attrappen in Tests ein, bei Menschen 26 Prozent. Die Autoren schreiben, Tests mit Attrappen seien womöglich leichter automatisch zu erzeugen, aber weniger wirksam darin, echtes Zusammenspiel zu prüfen (Quelle: Hora und Robbes, MSR 2026).
Was das für Fehler heißt, zeigt ein Hinweis von anderer Seite. Ein Anbieter von Code-Prüfung hat 470 offene Code-Änderungen ausgewertet: KI-mitgeschriebene Änderungen hatten im Schnitt 10,83 Befunde, rein menschliche 6,45. Logikfehler waren 75 Prozent häufiger (Quelle: CodeRabbit, 2025). Das ist ein Anbieter-Bericht mit kleiner Stichprobe, gemessen mit dem eigenen Werkzeug. Der Punkt für dich: In den Logikfehlern wohnen deine Geschäftsregeln.
Der Agent macht dabei nichts falsch. Er tut, wofür er gelobt wird, und gelobt wird grün. Sagst du ihm „schreib Tests“, bekommst du Tests. Sagst du ihm, welche Regel geschützt werden soll, bekommst du einen Nachweis.
Im August habe ich in „Schrödingers Doomer“ hergeleitet, dass Verifikation zu den drei Dingen gehört, die wertvoller werden, sobald Code fast nichts mehr kostet. Dort steht auch, dass 96 Prozent der befragten Entwickler:innen dem KI-Code nicht ganz trauen und nur 48 Prozent ihn immer prüfen (Quelle: Sonar, 2026). Hier nehme ich mir genau diesen einen Punkt vor.
Was nichts kostet, taugt nicht als Maßstab. Du brauchst also einen anderen.
Änderungen, die Tests anfassen
Änderungen, die Attrappen einbauen
Anteil der Änderungen in quelloffenen Projekten. Attrappen (Mocks) ersetzen im Test ein echtes System durch eine Nachbildung, die nur das Erwartete antwortet.
Quelle: Hora und Robbes, MSR 2026. 1,2 Mio. Änderungen, 2.168 Projekte. Gezählt wurden Attrappen, nicht entgangene Fehler.
03
Wie kannst du Software überprüfen, die eine KI gebaut hat?
Mit einer Frage pro Regel: Welcher Nachweis schützt sie, und sitzt er dort, wo ein Fehler wehtun würde?
Der andere Maßstab ist erstaunlich unspektakulär. Er passt auf ein Blatt.
Du kennst dein Geschäft. Du weißt, was nie passieren darf. Das reicht als Anfang.
Deine Regeln findest du mit drei Fragen. Was wäre dir vor einer Kundin peinlich? Was kostet sofort Geld, wenn es schiefgeht? Was darf nie bei der falschen Person landen?
Bei Maren sind es diese fünf Sätze:
- Eine Abrechnung geht nie an den falschen Haushalt.
- Eine Rechnung geht nie doppelt raus.
- Was gespeichert ist, ist nach einem Neustart noch da.
- Gesperrt schlägt freigegeben. Ist ein Konto gesperrt, geht nichts raus, egal welche anderen Rechte gesetzt sind.
- Ohne zweite Freigabe keine Auszahlung über 500 Euro.
Kein Fachwort drin. Jede Person im Büro kann sagen, ob der Satz stimmt.
Aus jedem Satz wird eine Kette: Regel, Nachweis, die Ebene, auf der er sitzt, und der Ablauf, in dem die Regel im Alltag vorkommt. Die alte Frage lautete: Wie viele Tests gibt es, und wie hoch ist die Abdeckung? Die neue ist die Nachweisfrage: Welcher Nachweis schützt diese Regel? Auf die erste Frage gibt es immer eine beeindruckende Zahl. Auf die zweite gibt es entweder eine Antwort oder ein ehrliches Schweigen.
Fachleute kennen die Idee als risikobasiertes Testen. Neu ist, wer sie stellen kann: Solange Tests teuer waren, war ihre Zahl ein brauchbares Zeichen für Sorgfalt, und die Frage blieb in der Entwicklung. Seit Tests fast nichts kosten, gehört sie zu der Person, die die Regeln kennt. Zu dir.
Warum der Regel-Teil beim Menschen bleibt, hat Martin Kleppmann von der Universität Cambridge auf den Punkt gebracht. Wenn das Prüfen selbst automatisch wird, wandert die Schwierigkeit dahin, die Anforderung richtig aufzuschreiben: Woher weißt du, dass das, was bewiesen wurde, auch das ist, was dir wichtig war (Quelle: Kleppmann, 2025)? Das nimmt dir keine Maschine ab. Und das ist eine gute Nachricht, denn dein Wissen über dein Geschäft wird wertvoller, wenn Code billiger wird.
Meiner Meinung nach sind die Regeln wichtiger als die Funktion, in der sie gerade programmiert sind. Code wird umgebaut. Die Regel bleibt.
Woher weißt du, dass das, was bewiesen wurde, auch das ist, was dir wichtig war?
04
Ist die Testpyramide überholt?
Ihre Grundidee trägt weiter. Neu ist die Sortierung: nach der Art des Fehlers, den ein Nachweis finden soll.
Du hast jetzt fünf Sätze. Bleibt die Frage, wo der Nachweis jeweils hingehört.
Die Testpyramide in zwei Sätzen: unten viele kleine, schnelle Tests, oben wenige große. Die Form stammt aus einer Zeit, in der kleine Tests billig liefen und große teuer waren, und in der jeder Test von Hand geschrieben wurde. Ich sortiere heute in vier Ebenen, jede mit einem Bild aus dem Hausbau.
Wenige echte Abläufe
Der End-to-End-Test, ich sage lieber Journey. Einmal durchs ganze Haus gehen: Abrechnung anlegen, speichern, Programm neu starten, Abrechnung wiederfinden. Marens Mittwoch wäre hier aufgefallen. Wichtig ist das Wort wenige. Eine Journey prüft den Weg. Hundert Zahlenvarianten prüft sie nicht.
Echte Grenzen
Der Integrationstest gehört überall dorthin, wo zwei Teile etwas übergeben: Oberfläche an Server, Server an Datenbank, Speichern an Wiederladen, alte Daten an neue Version. Mein Leitsatz dazu: Die Attrappe darf nie genau die Grenze ersetzen, die du prüfen willst.
Wie das in der Wirklichkeit aussieht, zeigen zwei große Ausfälle, bei denen kein Teil für sich verdächtig aussah und der Fehler an einer Übergabe entstand. Bei Cloudflare führte im November 2025 eine geänderte Berechtigung in einer Datenbank dazu, dass eine Konfigurationsdatei plötzlich doppelt so groß wurde. Das Programm, das sie liest, hatte ein Limit von 200 Einträgen, normal waren etwa 60 (Quelle: Cloudflare, 2025). Das Ergebnis war nach eigener Aussage der schlimmste Ausfall des Unternehmens seit 2019 (Quelle: Cloudflare, 2025). Kein Angriff, keine einzelne kaputte Funktion. Eine Übergabe. Bei Amazon Web Services war es im Oktober 2025 ein verborgenes Wettrennen zwischen zwei Automatisierungen, die sich gegenseitig einen Eintrag überschrieben (Quelle: Amazon Web Services, 2025).
Das Uptime Institute schätzt, dass Ausfälle immer öfter am Zusammenspiel von Systemen hängen und immer seltener an einer einzelnen Stelle (Quelle: Uptime Institute, 2026). Das ist eine Einschätzung aus der Rechenzentrums-Welt, keine Messung an kleinen Firmen. Marens Mittwoch folgt demselben Muster: Der Fehler sitzt an der Übergabe vom Speichern zum Neustart.
Schnelle Tests für Rechenlogik
Der Unit-Test bleibt. Für Preise, Fristen, Rundung und Umlageschlüssel sind kleine Tests unschlagbar: Sie laufen schnell. Sie zeigen sofort auf die kaputte Stelle. Es gibt dazu eine stärkere Variante, den Eigenschafts-Test. Statt drei Beispielen gibst du eine Eigenschaft vor, etwa: Die Summe aller Einzelabrechnungen ergibt immer die Gesamtkosten, egal welche Zahlen. Dann probiert die Maschine Hunderte Eingaben durch.
Eine Studie der Universität San Diego hat 40 Projekte untersucht. Ein solcher Eigenschafts-Test findet im Schnitt etwa 50-mal so viele eingebaute Fehler wie ein durchschnittlicher Unit-Test, 76 Prozent davon schon in den ersten 20 Eingaben (Quelle: Ravi und Coblenz, OOPSLA 2025). Gemessen wurde das an künstlich eingebauten Fehlern.
Ein Beweis für eine Handvoll Kernregeln
Die vierte Ebene klingt nach Universität und war bis vor Kurzem auch genau das. Dazu gleich mehr.
Mein Grundsatz für alle vier Ebenen: Kein Test fliegt raus, nur weil er klein ist. Und keiner bleibt, nur weil er grün ist.
Die Nachweise prüfen die fachliche Richtigkeit. Ob sich das Produkt richtig anfühlt, nach dir klingt und das Problem deiner Kundschaft löst, prüfst weiterhin du. Wie diese Abnahme aussieht, habe ich in „Vibe Coding testen“ beschrieben.
ein durchschnittlicher Unit-Test
ein Eigenschafts-Test: rund 50-mal so viele gefundene eingebaute Fehler
76 % davon in den ersten 20 Eingaben
Jedes Kästchen steht für die gefundenen Fehler eines durchschnittlichen Unit-Tests. Ein Eigenschafts-Test prüft eine Regel gegen viele erzeugte Eingaben statt gegen ein ausgedachtes Beispiel.
Quelle: Ravi und Coblenz, OOPSLA 2025. 40 Projekte, gemessen an künstlich eingebauten Fehlern.
05
Kann man Software beweisen statt testen?
Für wenige kleine, stabile Kernregeln ja. Der Beweis gilt für das Modell der Regel. Die Brücke zum echten Code prüfst du zusätzlich.
Ein Test ist eine Stichprobe. Du probierst zehn Fälle und hoffst, dass der elfte auch passt. Ein Beweis ist eine Rechnung, die für alle Fälle auf einmal gilt. So wie du nicht jede Zahl ausprobieren musst, um zu wissen, dass gerade plus gerade wieder gerade ergibt. Das Fachwort dafür heißt formale Verifikation.
Warum war das bisher nichts für den Mittelstand? Das berühmteste Beispiel, ein bewiesener Betriebssystem-Kern, hatte 8.700 Zeilen Code. Der Beweis brauchte 20 Personenjahre (Quelle: Kleppmann, 2025). Das war 2009.
Jetzt ändert sich etwas. Martin Kleppmann hat im Dezember 2025 vorhergesagt, dass KI dieses Verfahren aus der Nische in den Alltag der Softwareentwicklung holt (Quelle: Kleppmann, 2025). Nun sind Vorhersagen schwierig, besonders wenn sie die Zukunft betreffen (frei nach einem dänischen Sprichwort, das oft Niels Bohr zugeschrieben wird; Quelle: Quote Investigator, 2013). Amazon setzt solche Beweise nach eigener Aussage schon in mehreren Produkten ein und schreibt: Wenn KI-Agenten Geld bewegen und Anträge freigeben, reicht der übliche Ansatz des Testens nicht mehr aus (Quelle: Amazon Science, 2026). Das sagt ein Unternehmen, das selbst in diese Technik investiert.
Der Dämpfer kommt aus einem Vergleichstest von der Konferenz ICML 2026. Lässt man aktuelle Modelle bewiesenen Code für klassische Rechenverfahren schreiben, gelingt das je nach Beweissprache in 40,3, in 24,7 oder in nur 7,8 Prozent der Fälle (Quelle: Zhao et al., ICML 2026). Ein älterer Vergleich vom September 2025 kam mit anderen Aufgaben auf 82, 44 und 27 Prozent (Quelle: Beneficial AI Foundation und MIT, 2025). Ich lese das so: Es geht, die Quote hängt stark an Aufgabe und Beweissprache, und es ist weit weg von „auf Knopfdruck für das ganze Produkt“.
Wo die Grenze liegt, zeigt ein Fall vom April 2026. Kiran Gopinathan hat ein Programm zum Packen von Dateien genommen, das als korrekt bewiesen war, und es mit rund 105 Millionen zufälligen Eingaben beschossen. Im bewiesenen Teil: null Speicherfehler (Quelle: Gopinathan, 2026). Trotzdem fand er zwei Fehler, und beide lagen außerhalb dessen, was der Beweis abdeckt (Quelle: Gopinathan, 2026). Einer saß in einem Teil, für den niemand eine Regel aufgeschrieben hatte. Der andere im Unterbau, dem der Beweis blind vertraut. Sein Fazit, sinngemäß: Ein Beweis ist nur so stark wie die Fragen, die du zu stellen gedacht hast, und das Fundament, dem du vertraust.
Daraus folgt ein Muster, das Fachleute wiedererkennen werden. Die Regel einmal klein und exakt aufschreiben und beweisen. Dann den echten Code mit sehr vielen Zufalls-Eingaben gegen diese kleine Fassung laufen lassen und schauen, ob beide immer dasselbe sagen. Bei einem Projekt von Amazon ist das bewiesene Modell etwa zehnmal kleiner als der Produktionscode (Quelle: Lean FRO, ohne Datum). In einer älteren Auswertung von 2024 fanden die Beweise dort 4 Fehler, der Abgleich zwischen Modell und Code 21 weitere (Quelle: Disselkoen et al., 2024).
Donald Knuth hat diese Grenze schon 1977 in einen Satz gepackt, am Ende einer Notiz zu einem Algorithmus: „Beware of bugs in the above code; I have only proved it correct, not tried it.“ Also: Vorsicht vor Fehlern im Code oben, ich habe ihn nur als korrekt bewiesen, nicht ausprobiert (Quelle: Knuth, 1977). Bewiesen ist die Regel. Ob der Code ihr folgt, prüfst du zusätzlich.
Welche Regel taugt dafür? Sie ist eindeutig, gleiche Eingabe, gleiches Ergebnis. Sie ändert sich selten. Ein Fehler wäre teuer. Sie passt auf eine Seite und kommt ohne Oberfläche und ohne Netzwerk aus. Bei Maren sind das „Gesperrt schlägt freigegeben“ und „Ohne zweite Freigabe keine Auszahlung über 500 Euro“. Der Rest bleibt bei Journey und Grenztest.
Ein einzelnes Experiment, keine Messreihe. Innerhalb des Rahmens fand sich kein Fehler. Was der Rahmen nicht enthält, prüft der Beweis nicht.
Quelle: Gopinathan, April 2026. Einzelnes Experiment.
06
Woran merkst du, ob ein Nachweis etwas taugt?
Er wird rot, wenn du die Regel mit Absicht brichst. Bleibt er grün, hast du Dekoration.
Jetzt hast du vier Ebenen. Bleibt die unbequeme Frage: Woher weißt du, dass die neuen Nachweise mehr taugen als die alten 1.248 Haken?
Du baust den Fehler absichtlich ein. Lass das Speichern weg. Vertausch den Empfänger. Schalt die Sperre ab. Dann schau, wer es merkt. Die automatische Variante davon heißt Mutation Testing. Unter diesem Abschnitt kannst du es selbst ausprobieren.
Auch bei Fehlermeldungen ist Menge kein Beleg. Ein KI-Agent schrieb Eigenschafts-Tests für verbreitete Programmbibliotheken und meldete 984 Fehler. In einer Stichprobe von 50 Meldungen waren 56 Prozent echte Fehler, bei den am höchsten bewerteten Meldungen 86 Prozent (Quelle: Anthropic, 2026). Das Verfahren findet also echte Fehler. Trotzdem will auch die Fundliste geprüft werden.
Was der Umbau kostet
Der Umbau hat seinen Preis, und den solltest du kennen.
- Tempo. Ein Ablauf durch das ganze Produkt dauert länger als ein kleiner Test. Deshalb bleibt die Rechenlogik bei den schnellen Tests.
- Suchaufwand. Wird ein großer Ablauf rot, kann der Fehler an fünf Stellen sitzen. Ein kleiner Test zeigt mit dem Finger drauf. Darum brauchst du beides.
- Wackler. Große Tests sind manchmal rot und manchmal grün, ohne dass sich etwas geändert hat. Mein Grundsatz: Ein wackelnder Test gilt als kaputt. Er ist kein Grundrauschen.
- Scheinsicherheit. Ein Beweis klingt nach Endgültigkeit. Er deckt genau das ab, was aufgeschrieben wurde.
Für den Umbau gelten bei mir drei Regeln. Du kannst sie genauso von allen verlangen, die deine Software bauen, ob Mensch oder Agent. Alt und neu laufen eine Weile nebeneinander, bevor etwas gelöscht wird. Jede Löschung hat eine Begründung: Welche Regel war geschützt, und wer schützt sie jetzt? Und Erfolg misst du daran, wie viele relevante Fehlerarten du mit wie wenig gepflegtem Testcode erkennst. Die Zahl der gelöschten Tests ist kein Erfolg.
Ein Rauchmelder, den noch nie jemand mit Rauch geprüft hat, ist Deko an der Decke.
Mach es kaputt und schau, wer es merkt.
Wer merkt es?
Fehler „Speichern weglassen“: wird rot bei Grenztest gegen die echte Datenbank und Ablauf durchs ganze Produkt. Alle anderen Nachweise bleiben grün oder schlagen nur bedingt an.
AKleine Tests gegen Attrappen
bleibt gründie Attrappe sagt immer „gespeichert“BGrenztest gegen die echte Datenbank
wird rotnach dem Neuladen fehlt der DatensatzCAblauf durchs ganze Produkt
wird rotAbrechnung nach Neustart nicht wiederzufindenDBewiesene Kernregel plus Abgleich
bleibt grünkeine bewiesene Regel deckt das Speichern ab
Fehlerarten, die deine Auswahl abdeckt: 1 von 4
„Nur bedingt“ zählt nicht als abgedeckt: darauf kannst du dich nicht verlassen.
Kein einzelner Nachweis merkt alle vier Fehler.
Vereinfachtes Modell zur Veranschaulichung, keine Messung.
07
Wo fängst du an?
Mit fünf Sätzen auf einem Blatt: den Regeln, die in deinem Betrieb nie brechen dürfen.
Aufräumen fängt man an einer Ecke an. Hier ist deine: 60 Minuten, ein Blatt, fünf Sätze. Damit gehst du zu dem Menschen oder dem Agenten, der deine Software baut, und stellst zu jedem Satz die Nachweisfrage. Und gleich eine zweite hinterher: Zeig mir, dass er rot wird, wenn die Regel bricht.
Vier Antworten kannst du hören.
- „Dafür gibt es einen Ablauf-Test gegen das echte System.“ Gut.
- „Das ist in den Unit-Tests.“ Nachfragen: gegen die echte Datenbank oder gegen eine Attrappe?
- „Das testen wir manuell vor dem Release.“ Ehrlich, aber kein Nachweis, der von allein rot wird.
- Schweigen. Auch eine Antwort. Jetzt weißt du, wo du anfängst.
Ein Blick nach vorn, ohne Rechtsrat. Für Produkte mit digitalen Elementen gelten seit dem 11. September 2026 Meldepflichten aus dem europäischen Cyber Resilience Act, die Hauptpflichten ab dem 11. Dezember 2027. Die Verordnung verlangt eine technische Dokumentation der Mittel, mit denen der Hersteller die Anforderungen sicherstellt (Quelle: Verordnung (EU) 2024/2847). Und die neue EU-Produkthaftungsrichtlinie zählt Software ausdrücklich als Produkt, für Produkte, die ab Dezember 2026 auf den Markt kommen (Quelle: Richtlinie (EU) 2024/2853). Ob dein Projekt darunter fällt, klärt eine rechtliche Beratung, nicht ich. Die Richtung ist aber klar: Die Frage, womit du nachweist, dass deine Software tut, was sie soll, wird öfter gestellt werden. Wer sie mit fünf Sätzen und fünf Nachweisen beantworten kann, hat einen soliden Anfang.
Die Regeln aufschreiben ist Menschenarbeit. Das Nachweisen ist Maschinenarbeit. Wenn das sauber getrennt ist, musst du nicht mehr jeden Abend selbst durch das Programm klicken, um ruhig zu schlafen. Dein Kopf wird frei für das, was nur du kannst: das Gespräch mit der Kundin, die Entscheidung, was als Nächstes gebaut wird.
Jede wichtige Regel verdient einen Nachweis, genau dort, wo ein Fehler wehtun würde. Mit kleinen Teams baue ich diese Brücke: von fünf Sätzen im Büro zu Nachweisen im Produkt, die rot werden, sobald eine Regel bricht. Kam auf deine Nachweisfrage Schweigen, fängt dort meine Arbeit an.
Nimm dir heute ein Blatt und schreib den ersten Satz auf. Den, bei dem dir gerade etwas mulmig geworden ist.
Alle in diesem Artikel verwendeten Namen von Personen und Unternehmen sind frei erfunden. Ähnlichkeiten mit real existierenden Personen oder Unternehmen sind rein zufällig und nicht beabsichtigt. Die Beispiele dienen ausschließlich der Veranschaulichung.
| Regel | Nachweis | Ebene |
|---|---|---|
| Eine Abrechnung geht nie an den falschen Haushalt. | Ablauf vom Anlegen bis zum Versand, Empfänger geprüft | Journey |
| Eine Rechnung geht nie doppelt raus. | Grenztest gegen die echte Datenbank, zweimal absenden | Grenze |
| Was gespeichert ist, ist nach einem Neustart noch da. | Ablauf mit Neustart gegen das echte System | Journey |
| Gesperrt schlägt freigegeben. | bewiesene Regel, Code dagegen geprüft | Beweis |
| Ohne zweite Freigabe keine Auszahlung über 500 Euro. | bewiesene Regel, Code dagegen geprüft | Beweis |
Beispiel, erfundene Hausverwaltung
Passend zum Thema
Hol dir den kostenlosen Einstiegs-Guide: 10 konkrete Wege, wie du KI ab morgen produktiv einsetzt.
Hat dich dieser Artikel auf eine Idee gebracht? Lass uns herausfinden, welche Sinnvampire bei dir verschwinden können.